最近、やったほうがいいこととしてLLMO対策が挙げられます。
ただ、そのLLMOという言葉の意味を、社内で正確に説明できるでしょうか?
・「AIに引用されることらしい、という理解で止まっています…」
・「上司にSEOとの違いを聞かれても、答えられる自信がない…。」
マーケティングの新しい用語が増えるばかりで、手が止まっている方に向けて、この記事を書いています。
本記事では、LLMOの意味と読み方から、SEO・AEO・GEOとの違い、生成AIが引用元を選ぶ仕組み、そしてメリットと限界までを網羅的に解説します。総務省の統計や査読を経た学術論文にあたり、何が実証され、何がまだ確かめられていないのかまで線引きしました。
読み終わる頃には、LLMOを自分の言葉で説明できる状態と、社内を説得できる根拠が手元に残っているはずです。
ぜひ最後までご覧になり、AI検索時代の次の打ち手を決める材料にしてみてください。
なお、具体的なLLMO対策の手順は別記事で詳しく解説します。
・LLMOの意味と読み方、SEOとの5つの違い
・LLMO・AEO・GEO・AIOという似た用語の使い分け
・生成AIが引用元を選ぶ7つのステップとその仕組み
・LLMOのメリットと、「40%向上」など誤解されやすい限界
LLMOとは?
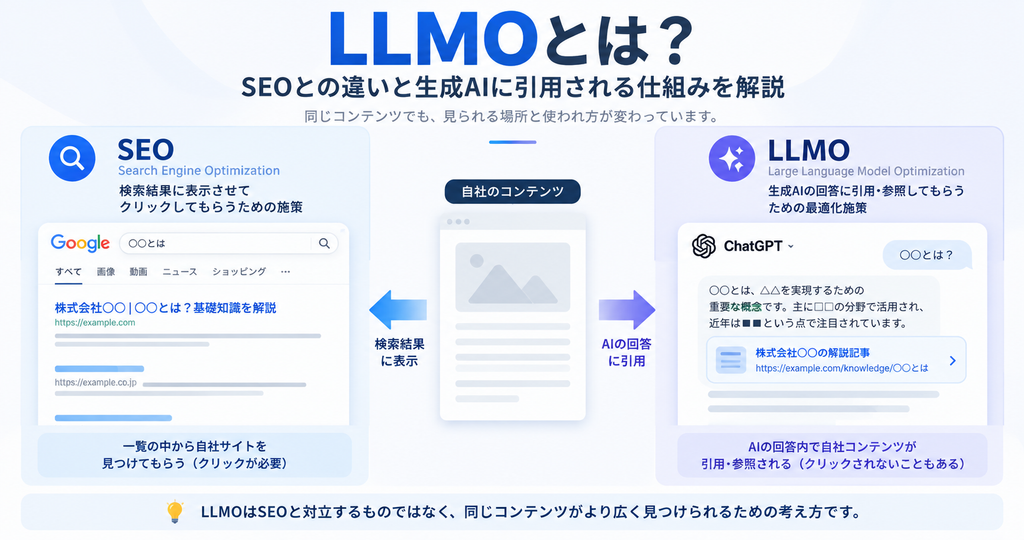
LLMOとは、生成AIが回答を作成する際に、自社のWebサイトや情報が引用・参照・言及されやすくするための一連の取り組みです。
対象となるのは、ChatGPTやGemini、Claude、Perplexity、そしてGoogleのAI Overviews(AIによる概要)といった、大規模言語モデルを基盤とするサービス群です。検索エンジンではなく、AIの回答そのものを最適化の対象に据えている点が特徴といえます。 LLMOの読み方と正式名称
LLMOは「エルエルエムオー」と読みます。正式名称はLarge Language Model Optimization(大規模言語モデル最適化)です。
LLMは大規模言語モデル(Large Language Model)の略で、膨大なテキストデータから学習した言語生成モデルを指します。ChatGPTやGeminiは、このLLMを土台に動いているサービスです。そのLLMに向けた最適化なので、LLMOという呼び名になっています。
なお、日本語では「LLMO対策」という言い方も定着しつつあります。意味するところは同じです。
LLMOのゴールは「順位」ではなく「引用・言及」
ここがSEOと決定的に異なる点です。SEOのゴールが「検索結果で上位に表示されること」だとすれば、LLMOのゴールは「AIの回答文のなかに自社が登場すること」になります。
登場のしかたには、大きく3つの状態があります。
- 引用(Citation) — 回答の根拠として出典リンク付きで参照される状態
- 言及(Mention) — リンクは付かないものの、回答文中に社名やサービス名が出てくる状態
- 推奨(Recommendation) — 「おすすめは〇〇です」のように、比較・選択の候補として挙がる状態
このうち、ビジネス成果に直結しやすいのは3の推奨です。ただし、そこに至る前提として1と2の積み上げが必要になります。
ポイントは、LLMOでは「1位」という概念が存在しないことです。 回答に含まれるか含まれないか、という二値に近い評価軸で戦うことになります。
LLMOの対象となる生成AI・AI検索サービス
LLMOが対象とするサービスは、大きく3つのタイプに分かれます。
▼ LLMOの対象となる主なサービス
| タイプ | 代表的なサービス | 特徴 |
|---|---|---|
| 対話型AIアシスタント | ChatGPT、Gemini、Claude | 会話のなかで質問に答える。Web検索を併用する場合としない場合がある |
| AI検索エンジン | Perplexity、Felo | 検索を前提とし、出典リンクを明示して回答する |
| 検索エンジン内のAI機能 | Google AI Overviews、AIモード、Microsoft Copilot | 従来の検索結果ページの上部などにAIの要約を表示する |
タイプごとに引用元の選び方は異なります。そのため、「ChatGPTで引用されたからGeminiでも引用される」とは限りません。この非対称性については、後ほど仕組みの章で詳しく扱います。
LLMOとSEOの違い
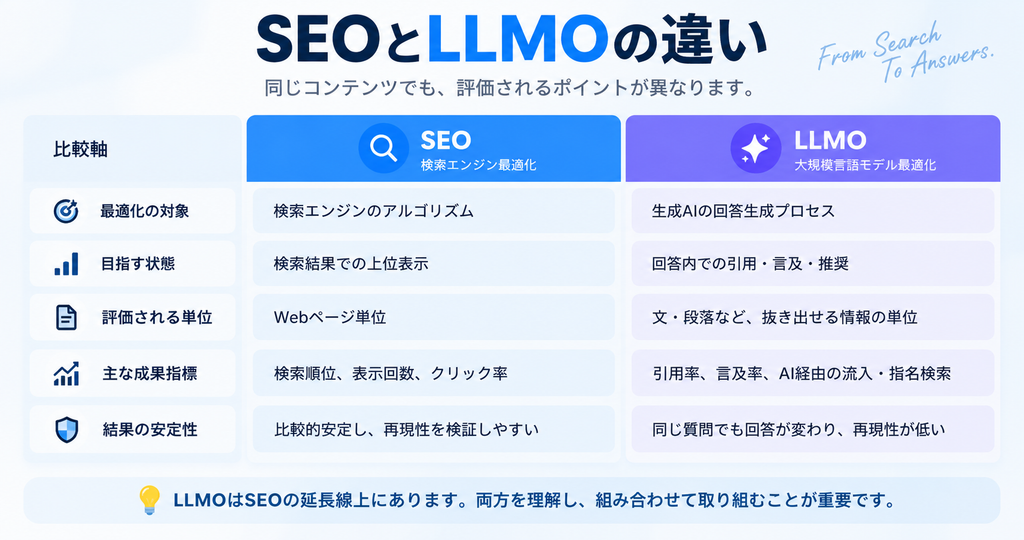
| 比較軸 | SEO(検索エンジン最適化) | LLMO(大規模言語モデル最適化) |
|---|---|---|
| 最適化の対象 | 検索エンジンのアルゴリズム | 生成AIの回答生成プロセス |
| 目指す状態 | 検索結果での上位表示 | 回答内での引用・言及・推奨 |
| 評価される単位 | Webページ単位 | 文・段落など、抜き出せる情報の単位 |
| 主な成果指標 | 検索順位、表示回数、クリック率 | 引用率、言及率、AI経由の流入・指名検索 |
| 結果の安定性 | 比較的安定し、再現性を検証しやすい | 同じ質問でも回答が変わり、再現性が低い |
とくに重要なのが3行目の「評価される単位」です。ここを取り違えると、施策の設計そのものがずれます。
評価されるのは「ページ」ではなく「一文」
検索エンジンは、ページ全体を1つの単位として評価し、順位を付けます。一方で生成AIは、取得した文書のなかから使える部分だけを抜き出し、回答文に組み込みます。
つまり、ページ全体の完成度が高くても、抜き出しやすい形になっていなければ回答には使われません。逆に、ページの一部分だけが引用されるケースも普通に起こります。
2026年に公開された生成エンジン最適化のサーベイ論文では、この点について次のように整理されています。
統計や定義、引用などの抽出可能な証拠は、多くの場合で利用を促進する。 ― 出典: Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026), arXiv:2607.14035
数値、定義文、出典付きの事実。こうした「そのまま切り出しても意味が通る情報」が、AIにとって使いやすい素材になります。同じ論文は、キーワードの詰め込みについては複数のベンチマークで無効またはマイナスだったとも報告しています。
SEOとLLMOは対立しない(土台は共通)
「SEOからLLMOに乗り換えるべきか」という問いを立てる方は少なくありません。しかし、この問いの立て方自体が実態と合っていません。
理由は単純で、生成AIが参照する情報の多くは、検索インデックスを経由して取得されるからです。クロールされず、インデックスもされないページは、そもそもAIの候補にすら入りません。
先ほどのサーベイ論文も、実務者への推奨として「関連性が高く、検証可能で、明確に構造化され、技術的に取得可能なページを作ること」を挙げています。これは従来のSEOで語られてきた基本と、ほとんど重なります。
結論として、LLMOはSEOの置き換えではなく、SEOの土台の上に積む拡張と捉えるのが実態に近いといえます。
LLMOとAEO・GEO・AIOの違い
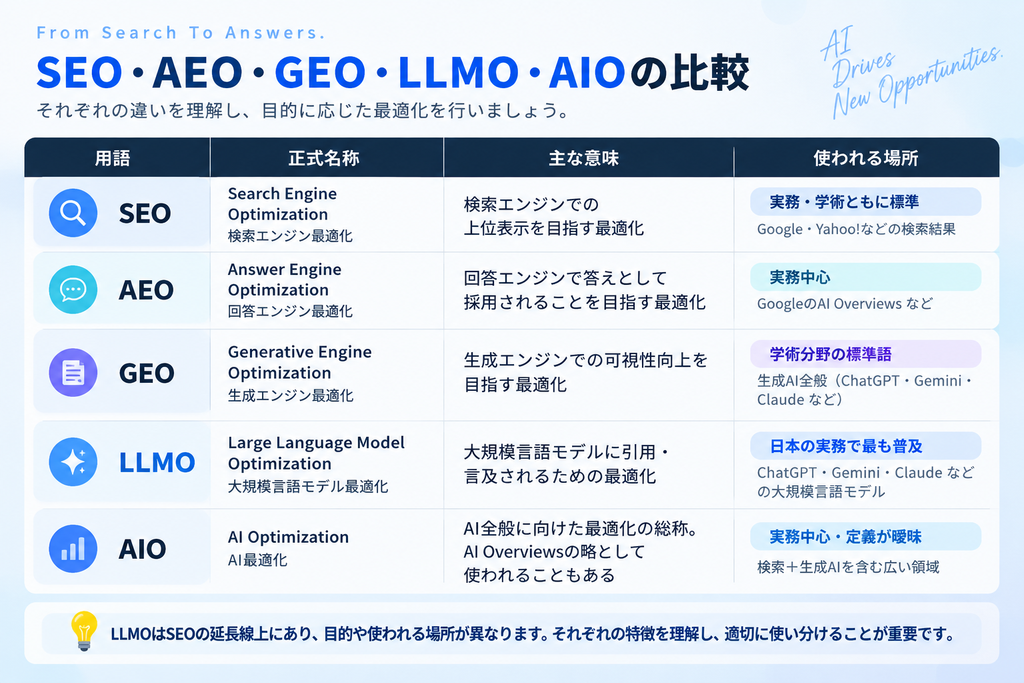
| 用語 | 正式名称 | 主な意味 | 使われる場所 |
|---|---|---|---|
| SEO | Search Engine Optimization | 検索エンジンでの上位表示を目指す最適化 | 実務・学術ともに標準 |
| AEO | Answer Engine Optimization | 回答エンジンで答えとして採用されることを目指す最適化 | 実務中心 |
| GEO | Generative Engine Optimization | 生成エンジンでの可視性向上を目指す最適化 | 学術分野の標準語 |
| LLMO | Large Language Model Optimization | 大規模言語モデルに引用・言及されるための最適化 | 日本の実務で最も普及 |
| AIO | AI Optimization | AI全般に向けた最適化の総称。AI Overviewsの略として使われることもある | 実務中心・定義が曖昧 |
学術研究の世界では、GEOが事実上の標準語です。 起点となったのは、2023年11月に投稿され、2024年のKDD(データマイニング分野の国際会議)に採択された論文「GEO: Generative Engine Optimization」(Pranjal Aggarwalら)です。この論文が生成エンジン最適化という枠組みと評価ベンチマークを提示しました。
一方、日本のマーケティング実務ではLLMOという呼び名が広く使われています。どの用語を使うかで施策の中身が変わるわけではありません。 社内やクライアントとの会話で言葉が食い違ったときは、この表を見せて認識を合わせれば十分です。
LLMOが注目される4つの背景
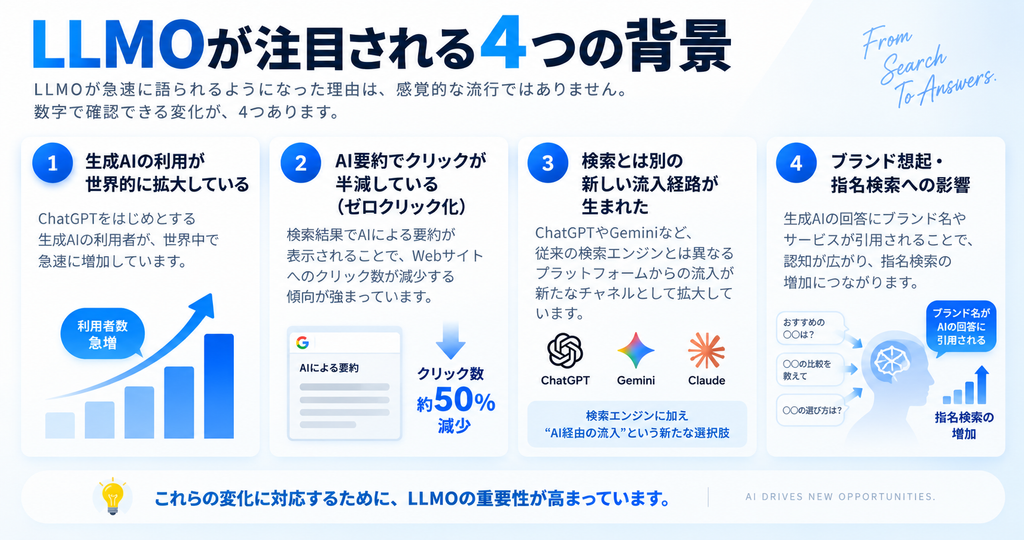
LLMOが急速に語られるようになった理由は、感覚的な流行ではありません。数字で確認できる変化が、4つあります。
- 背景1|生成AIの利用が世界的に拡大している
- 背景2|AI要約でクリックが半減している(ゼロクリック化)
- 背景3|検索とは別の新しい流入経路が生まれた
- 背景4|ブランド想起・指名検索への影響
背景1|生成AIの利用が世界的に拡大している
総務省の「令和7年版 情報通信白書」によれば、2024年度時点の生成AI個人利用経験率は次のとおりです。
▼ 生成AIの個人利用経験率(2024年度)
| 国 | 利用経験率 |
|---|---|
| 中国 | 48.5% |
| 米国 | 39.2% |
| ドイツ | 39.2% |
| 日本 | 23.7% |
日本は諸外国に比べて低い水準にとどまるものの、伸び率は急です。年代別では20代が44.7%と突出しており、若い層ほど生成AIを情報収集の入り口にしています。
この層が数年後に意思決定者になることを踏まえると、対応の遅れはそのまま接点の喪失につながります。
背景2|AI要約でクリックが半減している(ゼロクリック化)
米調査機関のピュー・リサーチ・センターは、2025年3月の実データをもとに、AI要約の有無で行動がどう変わるかを分析しました。米国成人900人のブラウジングデータから、68,879件のGoogle検索を対象にした調査です。
▼ AI要約の有無によるユーザー行動の違い(Pew Research Center, 2025年)
| 指標 | AI要約あり | AI要約なし |
|---|---|---|
| 検索結果リンクをクリックした割合 | 8% | 15% |
| そのままセッションを終了した割合 | 26% | 16% |
さらに、AI要約のなかに表示された出典リンクがクリックされたのは、全訪問のわずか1%でした。
数字が示しているのは明快な事実です。AI要約が出ると、サイトへのクリックはおよそ半分に減ります。 順位を守っていても流入が落ちるという現象は、ここから生まれています。
背景3|検索とは別の新しい流入経路が生まれた
減少の話だけでは片手落ちです。同時に、これまで存在しなかった流入経路も生まれています。
博報堂DYグループのONEDERが公開している調査によれば、AI検索エンジン経由のセッション数は2024年4月を起点として大幅な伸びを示しました。2026年7月時点の国内AI検索エンジン内シェアでは、ChatGPTが約66%を占めています。
母数はまだ従来の検索に遠く及びません。とはいえ、購買意欲の高いユーザーが「どれがいいか」をAIに直接聞く行動は、明確に増えています。この経路で候補に挙がるかどうかは、検討フェーズの入り口を左右します。
背景4|ブランド想起・指名検索への影響
LLMOの効果は、クリック数だけでは測れません。回答文のなかに社名が出るだけでも、ユーザーの記憶には残ります。
「〇〇業界のおすすめツールは?」という質問に対して、AIが3社を挙げたとします。そのうちの1社に入っていれば、ユーザーはその名前で改めて検索します。リンクを踏まれなくても、指名検索という形で成果に返ってくるわけです。
生成エンジン最適化のサーベイ論文には、AI Overviewsの起動率に関する興味深い報告もあります。全体では13.7%にとどまる一方、質問形式のクエリでは64.7%まで上昇するというものです。つまり、疑問形で調べられやすいテーマほど、AIの回答経由での接点が増えます。
LLMOの仕組み|生成AIが引用元を選ぶ7つのステップ
ここからが本記事の核心です。生成AIはどうやって引用元を選んでいるのか。ブラックボックスに見えますが、研究の蓄積によって処理の流れはかなり明らかになっています。
全体像|引用は7段階のステップで決まる
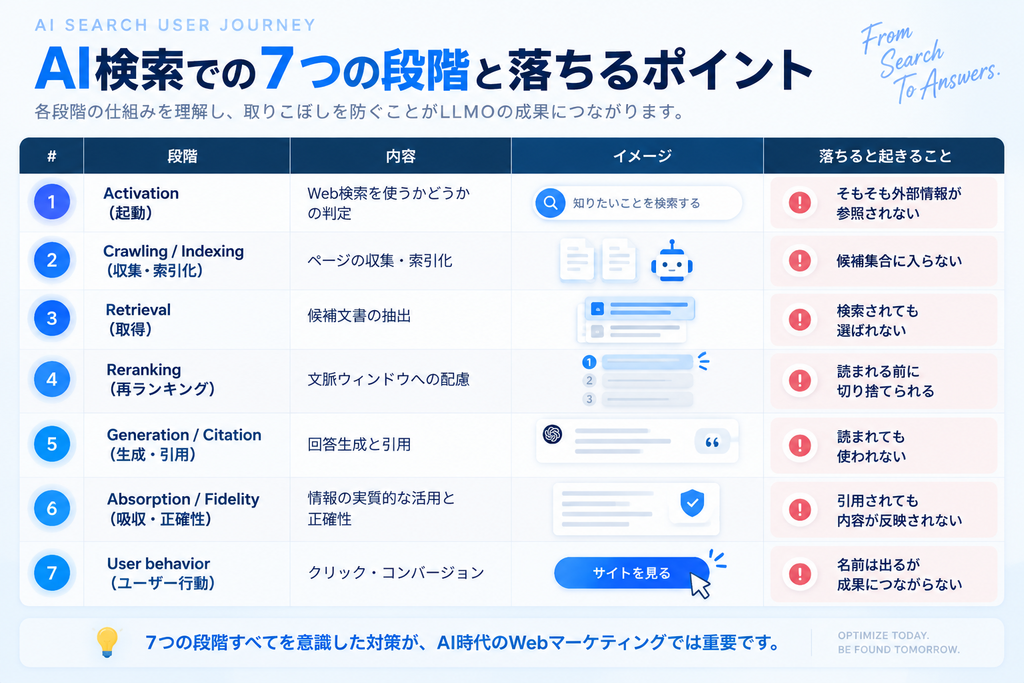
| # | 段階 | 内容 | 落ちると起きること |
|---|---|---|---|
| 1 | Activation(起動) | Web検索を使うかどうかの判定 | そもそも外部情報が参照されない |
| 2 | Crawling / Indexing | ページの収集・索引化 | 候補集合に入らない |
| 3 | Retrieval(取得) | 候補文書の抽出 | 検索されても選ばれない |
| 4 | Reranking(再ランキング) | 文脈ウィンドウへの配置 | 読まれる前に切り捨てられる |
| 5 | Generation / Citation | 回答生成と引用 | 読まれても使われない |
| 6 | Absorption / Fidelity | 情報の実質的な活用と正確性 | 引用されても内容が反映されない |
| 7 | User behavior | クリック・コンバージョン | 名前は出るが成果につながらない |
重要なのは、この7段階のどこか1つで落ちると、その先には進めないという点です。 「良い記事を書いたのに引用されない」という悩みの多くは、5段階目より手前で脱落しています。
ステップ①〜③|検索の起動・クロール・取得
最初の関門は、そもそもAIがWeb検索を行うかどうかです。学習済みの知識だけで答えられると判断されれば、外部の情報は参照されません。この場合、どれだけページを磨いても出番はありません。
次の関門がクロールと索引化です。AIクローラーがアクセスできない、あるいはJavaScriptに依存しすぎて内容を読み取れないページは、候補集合に入れません。ここは従来のテクニカルSEOと完全に重なる領域です。
3つ目が取得です。ユーザーの質問と文書の関連性が評価され、候補が絞り込まれます。サーベイ論文は、255万回を超える試行の検証にもとづき、クエリと文書の関連性、そして文脈内での位置が最も堅牢な要因だと結論づけています。
ステップ④〜⑤|再ランキングと生成・引用
取得された候補は、そのまま全部が使われるわけではありません。文脈ウィンドウ(AIが一度に読める範囲)には上限があるため、順序付けと取捨選択が行われます。ここが再ランキングです。
そして生成と引用の段階に入ります。この段階で効くのが、前章で触れた「抽出可能な証拠」です。 具体的な数値、明確な定義、出典の付いた事実。これらは回答文に組み込みやすいため、優先的に使われます。
一方、装飾的な表現や、文脈がないと意味が通らない文は使われにくくなります。「業界最高水準の品質」といった主張は、AIにとって検証も引用もできません。
ステップ⑥〜⑦|吸収・忠実度とユーザー行動
引用されれば終わり、ではありません。6段階目は、その情報が回答内容に実際に反映されているか(吸収)と、正確に反映されているか(忠実度)です。
ここで見落とされがちな指摘があります。サーベイ論文は、引用の表示は信頼性も裏づけも保証しないと明言しています。出典として並んでいても、回答本文がその内容を正しく反映しているとは限りません。
最後の7段階目がユーザー行動です。クリックされ、問い合わせや購買につながるか。前述のPew Researchの調査が示したように、この段階の通過率は決して高くありません。
従来の検索順位と引用元は一致しない
LLMOを考えるうえで、最も実務的な示唆がこれです。
サーベイ論文が引用する商用エンジンの観察データによれば、Google AI Overviewsが引用した文書のうち53%は、オーガニック検索の上位10位圏内に存在していませんでした。また、Bing ChatとPerplexityが引用するドメインの重複率は26%にとどまります。
つまり、次の2つが実態として成り立ちます。
- 検索1位を取っていても、AIに引用されるとは限らない
- あるAIで引用されても、別のAIでは引用されない
この非対称性こそが、SEOとは別にLLMOを考える必要がある理由です。 同時に、施策の効果を1つのサービスだけで判断してはいけない理由でもあります。
LLMOのメリットとデメリット
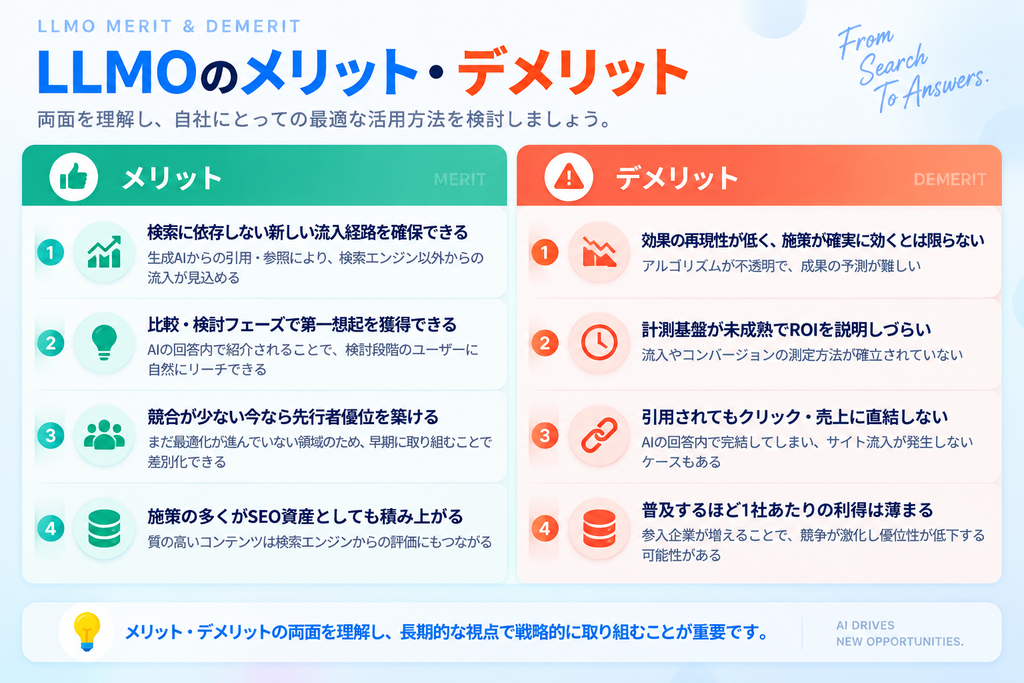
| メリット | デメリット |
|---|---|
| 検索に依存しない新しい流入経路を確保できる 比較・検討フェーズで第一想起を獲得できる 競合が少ない今なら先行者優位を築ける 施策の多くがSEO資産としても積み上がる | 効果の再現性が低く、施策が確実に効くとは限らない 計測基盤が未成熟でROIを説明しづらい 引用されてもクリック・売上に直結しない 普及するほど1社あたりの利得は薄まる |
LLMOに取り組む4つのメリット
メリット1|検索に依存しない新しい流入経路を確保できる
Google検索だけに依存した集客は、アルゴリズム変動のリスクを常に抱えます。生成AI経由の接点を持つことは、そのリスク分散になります。
母数はまだ小さいものの、伸び率は他のチャネルを大きく上回っています。早い段階で経路を確保しておけば、市場が拡大したときにそのまま乗ることができます。
メリット2|比較・検討フェーズで第一想起を獲得できる
「〇〇 おすすめ」「〇〇 比較」といった質問に対して、AIは数社を挙げて回答します。ここに含まれるかどうかは、検討リストに入るかどうかとほぼ同義です。
とくにBtoBでは、担当者が上長に提案する際の候補出しにAIが使われる場面が増えています。この瞬間に名前が出ることの価値は、クリック1件よりはるかに大きいといえます。
メリット3|競合が少ない今なら先行者優位を築ける
日本国内でLLMOに本格的に取り組んでいる企業は、まだ限られています。SEOのように十数年の蓄積で差がついた領域と異なり、スタートラインの差はほとんどありません。
ただし後述するとおり、この優位は普及とともに薄まります。先行者優位は「今だから成立する」性質のものだと理解しておく必要があります。
メリット4|施策の多くがSEO資産としても積み上がる
LLMOで求められる要素、たとえば構造の明快さ、一次データの提示、出典の明記、技術的な取得しやすさは、SEOの評価軸ともほぼ重なります。
つまり、仮にLLMOの効果が期待どおりでなくても、投資が完全に無駄になるわけではありません。 これはリスクの低さという意味で、実務上かなり大きな利点です。
LLMOに取り組む4つのデメリット
デメリット1|効果の再現性が低く、施策が確実に効くとは限らない
これが最大の課題です。生成AIは同じ質問に対しても回答が変動します。施策の前後で結果が変わっても、それが施策の効果なのか偶然なのかを切り分けにくい構造があります。
サーベイ論文が引用するC-SEO Benchの結果は、この難しさを端的に示しています。1,900のクエリに対して54の手法とドメインの組み合わせを検証したところ、主要な実験で有意にプラスの効果が確認されたのは3組み合わせのみでした。
デメリット2|計測基盤が未成熟でROIを説明しづらい
検索順位のように、誰もが同じ数字を見られる標準指標はまだ存在しません。引用率を測るツールは登場しているものの、計測方法も対象エンジンもばらばらです。
「投資に対してどれだけ返ってきたか」を経営層に説明する材料が、現時点では揃いにくいのが実情です。
デメリット3|引用されてもクリック・売上に直結しない
引用の獲得と、事業成果は別の話です。サーベイ論文は根拠の強さを段階分けしたうえで、「引用スコアがクリックや転換を予測する」という主張の裏づけは準実験1件のみであり、確信度は低いと評価しています。
引用数を増やすこと自体を目的化すると、成果につながらない作業を積み上げる結果になりかねません。
デメリット4|普及するほど1社あたりの利得は薄まる
C-SEO Benchの検証では、手法の採用が増えるにつれて個別の利得が減少するという結果が報告されています。全員が同じ最適化を行えば、相対的な差は消えるためです。
構造としては、かつてのSEOがたどった道と同じです。早期に取り組む価値はある一方、恒久的な優位を約束するものではありません。
LLMOに取り組むときの4つの注意点
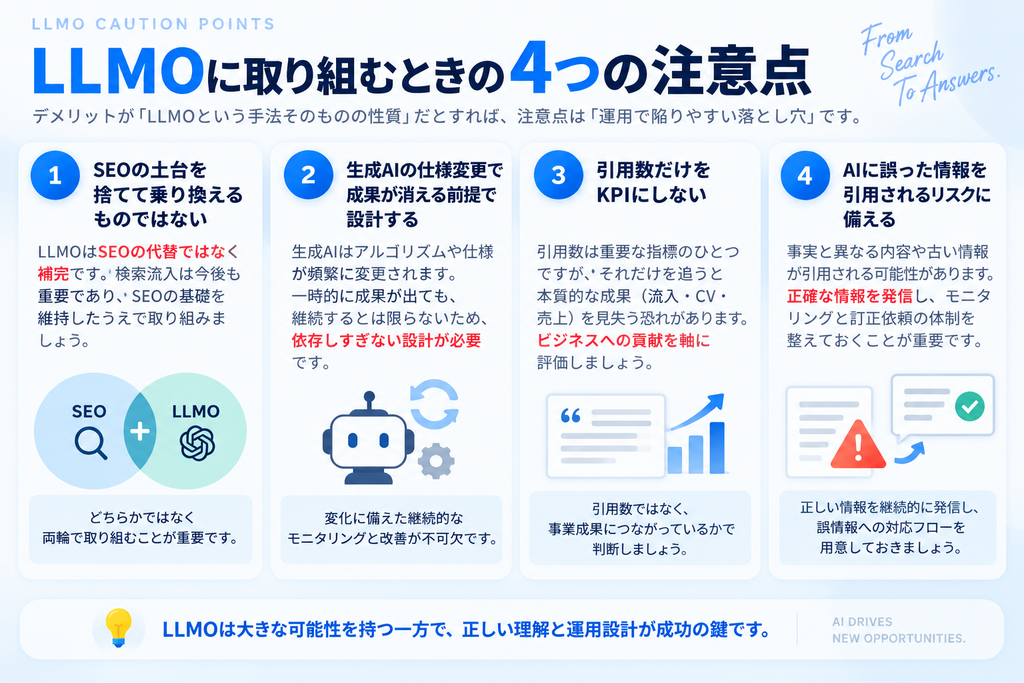
デメリットが「LLMOという手法そのものの性質」だとすれば、注意点は「運用で陥りやすい落とし穴」です。
注意点は、
- 注意点1|SEOの土台を捨てて乗り換えるものではない
- 注意点2|生成AIの仕様変更で成果が消える前提で設計する
- 注意点3|引用数だけをKPIにしない
- 注意点4|AIに誤った情報を引用されるリスクに備える
の4点になります。
注意点1|SEOの土台を捨てて乗り換えるものではない
繰り返しになりますが、クロールとインデックスを経ない情報は、生成AIの候補集合にすら入りません。SEOの基盤を削ってLLMOに人員を振り向ける判断は、7段階パイプラインの2段階目を自ら塞ぐ行為になります。
実際、2026年7月時点の国内データでは、従来型検索エンジン(Google・Bing・Yahoo! JAPAN)のシェアは前月比でプラスに転じ、AI検索エンジンのセッション数はマイナスとなりました(博報堂DYグループONEDER調べ)。移行は直線的には進んでいません。
注意点2|生成AIの仕様変更で成果が消える前提で設計する
生成AIのモデルも、検索を起動する条件も、引用の表示形式も、数か月単位で変わります。特定のサービスの挙動に最適化しすぎると、仕様変更で成果が消えます。
特定エンジンの癖ではなく、どのエンジンでも通用する「正確で構造化された情報」に投資するほうが、結果的に長持ちします。
注意点3|引用数だけをKPIにしない
LLMOの成果は単一の指標では捉えられません。サーベイ論文は、順位という一次元の概念に代えて、複数の軸を独立に見る考え方を提案しています。
▼ LLMOで見るべき可視性の主な軸
| 軸 | 意味 |
|---|---|
| 発見可能性 | そもそも検索・取得される確率 |
| 引用確率 | 回答に引用として載る確率 |
| 顕著性 | 回答内での位置や登場回数 |
| 吸収度 | 回答内容にどれだけ実質的に反映されたか |
| 忠実度 | 引用が正確になされているか |
| 経済的成果 | クリック、問い合わせ、転換 |
すべてを厳密に測る必要はありません。ただ、引用された回数だけを追うと、6番目の経済的成果から目が離れます。
注意点4|AIに誤った情報を引用されるリスクに備える
生成AIは、古い情報や文脈を欠いた断片を引用することがあります。廃止したサービス名や、改定前の価格が回答に出るケースは実際に起きています。
対策の起点は情報の鮮度管理です。更新日を明示し、古い記述を残さない。自社に関する記述の正確さを保つこと自体が、LLMOの重要な一部だといえます。
LLMO対策によって成果が出た4つの成功事例
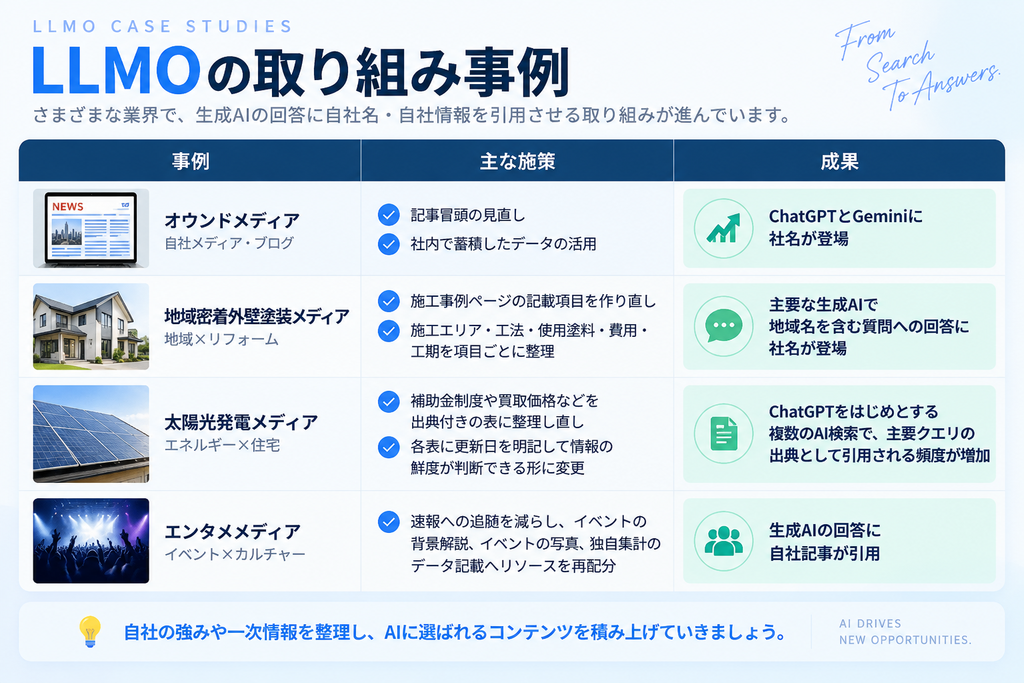
| 事例 | 主な施策 | 成果 |
|---|---|---|
| オウンドメディア | ・記事冒頭の見直し ・社内で蓄積したデータの活用 | ・ChatGPTとGeminiに社名が登場 |
| 地域密着外壁塗装メディア | ・施工事例ページの記載項目を作り直 ・施工エリア・工法・使用塗料・費用・工期を項目ごとに整理 | ・主要な生成AIで地域名を含む質問への回答に社名が登場 |
| 太陽光発電メディア | ・補助金制度や買取価格などを出典付きの表に整理し直し ・各表に更新日を明記して情報の鮮度が判断できる形に変更 | ・ChatGPTをはじめとする複数のAI検索で、主要クエリの出典として引用される頻度が増加 |
| エンタメメディア | ・速報への追随を減らし、イベントの背景解説、イベントの写真、独自集計のデータ記事へリソースを再配分 | ・生成AIの回答に自社記事が引用 |
事例1|オウンドメディア
課題:検索順位は上位を維持しているのに、主要記事のセッション数が前年比で約2割減少していました。時期を照合すると、対象クエリでAI Overviewsの表示が増えたタイミングと重なります。ChatGPTとGeminiに自社のサービスを尋ねても、回答に社名が一度も登場しない状態でした。
施策:記事冒頭の構成を全面的に見直し、結論と定義を60〜80字で先に置く形に統一。あわせて、社内に蓄積していた導入データを表形式で追加しました。技術面では、サービス概要ページを一次情報として整え、会社名・サービス名の表記を全チャネルで統一しています。
成果:約3か月後、主要8クエリのうち5クエリで生成AIの回答に社名が登場するようになりました。指名検索数は月間120件から310件へ増加し、セッション数の減少も下げ止まっています。
事例2|地域密着外壁塗装メディア
課題:「地域名+外壁塗装」の検索では上位を取れていました。ただ、生成AIに「◯◯市で外壁塗装を頼むなら?」と尋ねると、挙がるのは大手ポータルサイトばかりで自社の名前は出てきません。地域での実績はあるのに、AIがその実績を認識できる形になっていませんでした。
施策:施工事例ページの記載項目を作り直し、施工エリア・工法・使用塗料・費用・工期を項目ごとに整理。数値と固有名詞が揃った、AIが抜き出しやすい形にしました。地域特有の条件と塗料選定の関係も一次情報として解説し、第三者メディアや自治体系サイトでの言及を増やす広報活動を並行しています。
成果:約4か月後、主要な生成AIで地域名を含む質問への回答に社名が登場するようになりました。問い合わせフォームの「当社を知ったきっかけ」で生成AIを挙げた件数は、月6件発生しています。
事例3|太陽光発電メディア
課題:「太陽光発電は元が取れるのか」といった検討段階の質問が生成AIに流れ、記事へのクリックが減少していました。出典として引用されるのは大手の電力比較サイトが中心です。自社には設置実績のデータが蓄積されていたものの、記事内では文章のなかに埋もれていました。
施策:補助金制度や買取価格などを出典付きの表に整理し直し、各表に更新日を明記して情報の鮮度が判断できる形にしました。さらに、自社の設置実績から地域別・屋根形状別の発電量データを集計して公開しています。他社が持たない一次データを、そのまま引用できる形で提示した点が転換点になりました。
成果:約5か月後、ChatGPTをはじめとする複数のAI検索で、主要クエリの出典として引用される頻度が増加。AI検索経由の参照トラフィックは月280セッション発生しています。なお太陽光発電は費用や制度に関わる分野のため、断定を避けて前提条件を必ず明記する方針に統一しました。
事例4|エンタメメディア
課題:速報記事の本数で競合と勝負していましたが、生成AIの回答で引用されるのは公式発表や大手報道などの一次ソースでした。速報を追う限り、自社が引用される余地はほとんどありません。「早さ」で戦う設計そのものが、LLMOと相性の悪い構造でした
施策:速報への追随を減らし、イベントの背景解説、イベントの写真、独自集計のデータ記事へリソースを再配分。月次の独自ランキングも定期公開しました。執筆者プロフィールと詳細情報を各記事に明記し、誰がどのように書いた情報なのかを明確にしています。
成果:約6か月後、のクエリで、生成AIの回答に自社記事が引用されるようになりました。全体のPVは横ばいながら、指名検索数は約1.4倍に増加。1セッションあたりの閲覧ページ数も1.8ページから2.3ページへ改善しました。
LLMO対策の社内体制の作り方
LLMOは、SEO担当者だけで完結しません。
- 情報の正確性
- 技術的な取得しやすさ
- 社外での言及量
この3つが揃って初めて機能するためです。
誰が担当すべきか|SEO担当・広報・情報システムの役割分担
| 部門 | 主な担当領域 |
|---|---|
| SEO・コンテンツ担当 | 情報の構造化、一次データの整備、更新管理 |
| 広報・PR | 社外メディアでの言及獲得、公式情報の一貫性維持 |
| 情報システム・開発 | クローラーのアクセス確保、サイトの技術的な取得しやすさ |
3部門のいずれかが欠けると、7段階のステップのどこかで詰まります。
LLMOが「SEOチームの追加業務」として扱われると失敗しやすいのは、この構造が理由です。
最低限そろえたい3つの役割
大規模な専任チームは必要ありません。次の3つの役割が兼任でも確保できていれば動きます。
- オーナー — 目的とKPIを決め、部門をまたいで意思決定する
- コンテンツ責任者 — 情報の正確性と鮮度に最終責任を持つ
- 技術窓口 — クローラー設定やサイト構造の変更を実行できる
内製と外注の判断基準
判断の軸は、社内に一次情報があるかどうかです。
自社にしかないデータや事例を持っている企業は、内製の価値が高くなります。それが最大の差別化要因になるためです。一方、計測設計や複数エンジンのモニタリングは、専門ツールと知見が必要なため外部の力を借りたほうが早い領域といえます。
経営層への説明で押さえるべき論点
前述のとおり、LLMOはROIを断言しにくい施策です。過大な効果を約束すると、後で信頼を損ないます。
説明の際は、次の3点を正直に伝えるのが現実的です。
- 生成AI経由の接点は伸びているが、母数はまだ小さい
- 効果の再現性は低く、確実な保証はできない
- ただし施策の多くはSEO資産としても機能するため、投資が無駄になりにくい
「不確実だが、下振れの小さい投資」という位置づけが、現時点での正確な説明です。
LLMOでよくある3つの誤解
最後に、実務でよく耳にする誤解を3つ取り上げます。いずれも一次情報にあたると、事実と少しずれていることがわかります。
誤解1|「LLMOで可視性が40%上がる」
この数字は、2023年のGEO論文が報告した「最大40%の可視性向上」を出典としています。数字自体は実在します。
ただし、2026年のサーベイ論文は、この主張を明確に評価し直しています。同論文は「GEOが可視性を40%向上させる」という一般化された主張について、特定条件下での相対的な最大値であり、一般論としては否定的だと位置づけました。
「最大40%」であって「平均40%」ではありません。 提案時に使う場合は、この区別を落とさないよう注意が必要です。
誤解2|「llms.txtを置けば引用される」
llms.txtは、AI向けにサイトの情報をまとめて提示するためのファイル形式として提案されたものです。しかし、Googleは2026年6月15日に検索セントラルで見解を公開しています。
Google検索(生成AI機能を含む)に表示されるために、llms.txtファイルやその他の「特殊な」マークアップを設置する必要はない。 ― 出典: Google 検索セントラル(2026年6月)
Googleの検索システムはこのファイルを使用していません。AIエージェントとの連携を想定する場合には意味を持つ一方、検索での引用獲得を目的に導入する必要性は低いというのが現時点の整理です。
誤解3|「SEOはもう不要になる」
これは最も広く流通している誤解です。事実は逆で、生成AIが参照する情報の大部分は検索インフラの上に乗っています。
数字でも確認できます。2026年7月時点の国内データでは、従来型検索エンジンのシェアが前月比プラスとなる一方、AI検索エンジンのセッション数は前月比マイナスでした。移行は一直線には進んでおらず、揺り戻しもあります。
サーベイ論文の結論も同じ方向を向いています。同論文は、根拠にもとづく推奨として「関連性が高く、検証可能で、明確に構造化され、技術的に取得可能なページを作り、その後に段階別に測定する」という保守的なアプローチを示しました。これは従来のSEOの延長線上にあります。
LLMOに関するよくある質問(FAQ)
- Q1. LLMOとは何の略ですか?読み方は?
-
LLMOはLarge Language Model Optimization(大規模言語モデル最適化)の略で、「エルエルエムオー」と読みます。生成AIの回答に自社の情報が引用・言及されやすくするための最適化を指します。
- Q2. LLMOとSEOはどちらを優先すべきですか?
-
まずSEOの土台を固めることをおすすめします。クロールとインデックスを経ていないページは、生成AIの候補集合にも入らないためです。SEOの基盤がある企業が、その上にLLMOを積む形が現実的な順序といえます。
- Q3. LLMOの効果はどうやって測定するのですか?
-
現時点で標準的な指標は確立されていません。主要な生成AIに自社に関わる質問を定期的に投げ、引用・言及の有無を記録する方法が実務上の基本です。あわせて、指名検索数やAI検索経由の参照トラフィックも補助指標として追います。単一の数字で判断しないことが重要です。
- Q4. LLMOとGEO・AEOは別物ですか?
-
ほぼ同じ対象を指す用語です。学術分野ではGEO(Generative Engine Optimization)が標準的に使われ、日本の実務ではLLMOが広く定着しています。呼び名が違っても、施策の中身に本質的な差はありません。
- Q5. 中小企業でもLLMOに取り組む意味はありますか?
-
あります。生成AIの引用は広告予算の大小で決まるものではなく、情報の正確さと構造の明快さが評価軸になるためです。特定領域に絞った専門的な一次情報を持つ企業は、規模にかかわらず引用される可能性があります。
まとめ|LLMOとは何かを正しく理解することが第一歩
本記事の要点を振り返ります。
- LLMOとは、生成AIが回答をつくる際に自社が引用・言及されるようにする最適化のこと
- SEOとの最大の違いは、評価される単位が「ページ」ではなく「抜き出せる一文」である点
- 生成AIの引用は7段階のパイプラインで決まり、どこか1段階で落ちれば先には進めない
- Google AI Overviewsの引用文書の53%は検索上位10位圏外であり、順位と引用は一致しない
- LLMOには再現性の低さと計測の難しさという限界があり、過大な効果を前提にすべきではない
- ただし施策の多くはSEO資産としても機能するため、下振れの小さい投資といえる
まず取り組むべきは、施策の実行より前に、自社が生成AIからどう見えているかを確認することです。主要な生成AIに自社と競合の名前を尋ね、現在地を把握するところから始めてください。
具体的な施策の手順については、別記事で詳しく解説します。